

'합성 데이터' 방식 도입... 전문성과 함께 학습을 통해 얻은 일반화 성능도 유지
[녹색경제신문 = 이지웅 기자] 박찬영 카이스트 산업및시스템공학과 교수 연구팀이 연합학습의 고질적인 성능 저하 문제를 해결하고, AI 모델의 일반화(Generalization) 성능을 크게 향상시키는 새로운 학습 방법을 개발했다.
연합학습은 여러 기관이 데이터를 직접 주고받지 않고도 공동으로 AI를 학습할 수 있는 방식이다. 해당 방식을 사용할 경우, 기존의 폭넓은 지식이 희석되면서 AI가 특정 기관의 데이터 특성에만 과도하게 적응하는 ‘지역 과적합(Local Overfitting)’ 문제가 발생해 최적화 과정에서의 문제가 발생한다.
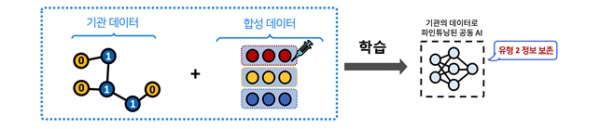
연구팀은 이를 해결하기 위해 ‘합성 데이터(Synthetic Data)’ 방식을 도입했다.
각 기관의 데이터에서 핵심적이고 대표적인 특징만을 추출해 개인정보를 포함하지 않는 가상 데이터를 생성하고, 이를 파인튜닝 과정에 적용한 것이다.
이로써 각 기관의 AI는 개인정보 공유없이 자신의 데이터에 맞춰 전문성을 강화하면서도, 공동학습으로 얻은 일반화 성능을 잃지 않게 되었다.
연구 결과 해당 방법은 의료·금융 등 데이터 보안이 중요한 분야에서 특히 효과적일 뿐 아니라, 소셜미디어나 전자상거래처럼 새로운 사용자와 상품이 지속적으로 추가되는 환경에서도 안정적인 성능을 발휘했다.
새로운 기관이 협력에 참여하거나 데이터 특성이 급격히 변하더라도 AI가 혼란스러워하지 않고 안정적으로 성능을 유지할 수 있음을 보여줬다.
박찬영 교수는 “이번 연구는 데이터 프라이버시를 지키면서도 각 기관의 AI가 전문성과 범용성을 동시에 보장하는 새로운 길을 열었다”며 “의료 AI, 금융 사기 탐지 AI처럼 데이터 협업이 필수적이지만 보안이 중요한 분야에서 큰 도움이 될 것”이라고 말했다.
한편, 이번 연구는 정보통신기획평가원의 지원을 받은 ‘강건하고 공정하며 확장 가능한 데이터 중심의 연속 학습’과제와 한국연구재단의 지원을 받은 ‘그래프 파운데이션 모델: 다양한 모달리티 및 도메인에 적용 가능한 그래프 기반 기계 학습’과제와 ‘데이터사이언스융합인재양성 사업’의 성과다.
이지웅 기자 game@greened.kr
